因JS埋点漏掉不执行脚本的爬虫、并发下UV会多算,第三方统计又需交出数据,站点改用nginx日志统计:内网统计机定时增量拉取只读日志,本地解析来源、设备、归属地和机器流量,看板与站点卡片同源。站点端仅两个PHP文件,不改主题、不装JS,数据不出内网。
做这个站的访问统计时,我先装了WordPress 统计插件,用了两天就把它卸了——数字看着漂亮,做决策时全是错的:PV 忽高忽低、UV 涨了流量却没涨、回访率永远是 0。问题出在 JS 埋点:采集器带着正常的 Chrome UA 却不执行 JS,插件根本统计不到;而插件算 UV 的方式(把访客 ID 逗号拼起来再数出现次数)在并发写入时还会多算。
同主题的另一篇:如果你关心的是「怎么把 nginx 日志拉回家自己解析、自己入库、自己出图」,看这篇 用 Nginx 访问日志自建网站统计面板。本文不重复那套流程,重点讲看板怎么设计、爬虫流量怎么辨真假、以及看板数字和站长工具对不上时该信谁。
后来我把思路换掉:不埋点,直接解析 nginx 访问日志。nginx 早就把每一次请求都记下来了,UV、会话、来源、设备、归属地、停留时长全都能从里面算出来,而且日志就在自己服务器上,想算什么都行。今天这篇就把这套东西完整拆开讲——架构怎么搭、数据怎么入库、爬虫怎么辨真假、以及那些「看板数字和站长工具对不上」的坑我都踩了一遍。
先说结论:这套方案站点端只需要两个 PHP 文件(一个只读导出、一个只写快照),不改主题、不装 JS、不连任何第三方统计服务。数据不出内网,看板只在家里开。
一、为什么不用 JS 埋点,也不建议用第三方统计
先讲清楚为什么走日志这条路,这不是偏好问题,是三条硬约束。
1.1 埋点统计不到爬虫,而这个站的流量 95% 是机器
看板实测 20 天共44.0 万条请求,其中被判定为机器的有 417,080 条,占 94.8%;真实访客只有 22,985 条,占 5.2%。这个比例放到任何普通博客身上都属于极端值,原因是站点开了 fastcgi_cache 且用了全站 CDN式的静态缓存,扫描器探测成本极低,于是全天都有各种脚本在扫 /wp-admin、/.env、/phpmyadmin 这类路径。
关键在于:这些扫描器大多带着正常的浏览器 UA,但它们不执行 JS。所以埋点方案看到的「真实流量」比日志口径少一大截,而你在站长工具里看到的又是另一套数字——三套数据对不上,最后你不知道信谁。
1.2 埋点方案本身会漏计、会算错
我这边的旧插件出现过一次很典型的崩塌:10-01 的 PV 是 334,到 10-05 掉到 26,单调下跌;而同期日志口径只从 344 掉到 276。日志数据平缓,埋点数据崩了——这说明埋点会漏,不是流量真跌了。另一个问题是 UV 字段用「逗号拼接访客 ID 再 substr_count 计数」实现,并发写入时会重复计数。
1.3 第三方统计等于把数据交出去
国内外的统计服务多数要备案、要加载外部脚本、要处理 cookie 同意弹窗。对一个纯技术博客来说,收益远小于成本:广告投放不需要,流量分析自己看日志就够,还少一层被第三方出问题的风险。
日志口径的天花板要先知道:日志只知道「谁在什么时间请求了什么」,不知道用户怎么在页面上滑动、点了哪里。所以停留时长只能估算(同一访客相邻两次请求的间隔),最后一次访问和单页访问算不出来,会显示 —。要精确到秒只能埋 JS,日志做不到。想清楚这一点再决定。
二、整体架构:日志怎么从服务器跑到内网
最关键的一个设计决定是:统计机不直连网站服务器。内网机器主动发起 HTTPS 请求去拉日志,网站端只提供一个只读接口。这样做的好处是网站端不需要监听任何入站端口,也不需要给内网开防火墙。
997wan 服务器                内网统计机(192.168.11.3)
n997-stats-export.php ──HTTPS POST──▶ fetch.py(每 5 分钟拉增量)
  只读日志 · token 校验├─ 解析 UA / 来源 / 设备
                         ├─ ip2region 查归属地(离线库)
                         ├─ 标记机器流量
                         └─ 写 stats.db
                                │
                              web.py :8089 看板
                                │
                              push.py(同一轮,拉完即推)
                                │ HTTPS POST
n997-stats-snapshot.php ◀──────────┘
  token 校验后写入 wp_options
        │
        └─ 侧边栏卡片 AJAX 读取 → 展示
这张图里有三个值得单独说明的设计。
2.1 增量靠日志字节 offset,不重复不遗漏
最笨的办法是每次全量重导日志,越滚越慢。这里用的是标准的 offset 增量:meta 表记下上次读到第几个字节,下次从那儿接着读。配合日志轮转检测(inode 变了就从头重导),既能保证不重不漏,也不会随着日志增长而变慢。
site:  www.997wan.com 的 /www/wwwlogs/997wan.com.log
增量:  meta.log_offset = 94677086 字节
同步:  systemd timer 每 5 分钟触发一次
实测:  20 天 44 万条 / 单次拉 2 万条上限
2.2 归属地用离线库,不依赖任何在线接口
用ip2region 的离线库(51.8 万条),查询完全本地完成。好处是没有外部依赖、没有速率限制、不会被接口挂掉拖垮整个看板。代价是数据更新滞后,但查「这是国内还是国外、省市是哪儿」够用了。
2.3 看板和站点侧卡片同源同口径
我原来有两个数据源:看板的日志口径,和站点侧边栏卡片的 JS 信标口径,两边数字长期打架。改法是让卡片不再自己计数,只读统计机推来的快照。
| 卡片字段 | 口径 |
|---|---|
| 今日浏览 | 今日 kind='page' 且 bot=0 的请求数 |
| 今日 IP | 同上,去重 IP 数 |
| 近 7 天浏览 | 滚动 7 天(含今天) |
| 本月浏览 | 本自然月 1 号至今 |
| 另有机器请求 N 次 | 今日 bot=1 的全部请求(不限类型) |
| 人均停留 | 今日人均停留,相邻请求间隔估算 |
这里有个细节值得单独说:近 7 天用滚动窗口,不用自然周。自然周在周一会等于「今日」,看着像坏了。改口径之后卡片和看板数字完全一致,看板整页还不会被 fastcgi_cache 缓存住。
三、网站端:一个只读导出接口怎么写
站点端只要一个 PHP 文件,严格只读 + token 校验。它不是通用日志分析器,只做一件事:按字节区间吐原始日志文本给统计机。
<?php
declare(strict_types=1);
const N997_TOKEN = '你的随机 token';
const N997_LOG   = '/www/wwwlogs/997wan.com.log';

header('Content-Type: application/json; charset=utf-8');
header('Cache-Control: no-store, no-cache, must-revalidate, max-age=0');
header('X-Robots-Tag: noindex');

$tok = (string)($_POST['token'] ?? $_GET['token'] ?? '');
if (!hash_equals(N997_TOKEN, $tok)) {
    http_response_code(403);
    echo json_encode(['ok' => 0, 'error' => 'forbidden']);
    exit;
}

clearstatcache(true, N997_LOG);
$size = (int)filesize(N997_LOG);
$ino  = (string)fileinode(N997_LOG);
$offset = (int)($_POST['offset'] ?? $_GET['offset'] ?? 0);
$max    = (int)($_POST['max'] ?? $_POST['max'] ?? 20000);
if ($max > 50000) { $max = 50000; }
if ($offset < 0 || $offset > $size) { $offset = 0; }

$f = @fopen(N997_LOG, 'rb');
if (!$f) { http_response_code(500); exit; }
if ($offset > 0) { fseek($f, $offset); }
3.1 四个必须注意的点
| 要求 | 原因 |
|---|---|
hash_equals() 比对 token |
普通 === 会因短路比较泄露前缀,是定式攻击 |
返回 X-Robots-Tag: noindex |
这是个统计接口,不该进搜索索引 |
clearstatcache(true, ...) |
PHP 进程会缓存文件大小和 inode,不清会一直读到旧值 |
| 把 inode 一起返回 | 统计机靠它判断日志是否轮转过 |
最后补一个容易漏的安全细节:这个 PHP 文件放在站点根目录是能被访问到的,所以 token 一定要够长够随机,并且文件里不要出现数据库密码之类的信息。它只读日志,日志里已经有你的访客 IP 了。
四、统计机:数据入库与口径定义
4.1 单表结构:25个字段够用一年
没有用时序数据库,也没有上ClickHouse。一张 SQLite 表,44 万行,覆盖 20 天,完全够用——个人站最高也就每天几万请求,一年才一千多万行。
CREATE TABLE visits(
  id INTEGER PRIMARY KEY AUTOINCREMENT,
  ts INTEGER, date TEXT, hour INTEGER,
  ip TEXT, country TEXT, region TEXT, city TEXT, isp TEXT,
  method TEXT, path TEXT, query TEXT,
  status INTEGER, bytes INTEGER,
  referer TEXT, ref_host TEXT, ref_type TEXT,
  ua TEXT, device TEXT, os TEXT, browser TEXT,
  bot INTEGER, kind TEXT, dwell INTEGER, dwell_calc INTEGER,
  sid TEXT, engine TEXT
);
CREATE INDEX idx_visits_tsON visits(ts);
CREATE INDEX idx_visits_ip     ON visits(ip);
CREATE INDEX idx_visits_sid    ON visits(sid);
CREATE INDEX idx_visits_path   ON visits(path);
CREATE INDEX idx_visits_date   ON visits(date);
CREATE INDEX idx_visits_engine ON visits(engine);几个关键字段的语义:kind 区分 page(页面)/ static(静态资源)/ system(wp-admin、wp-json)/ scan(扫描探测);ref_type 把来源分成直接访问、搜索引擎、站内、外部链接四类;dwell_calc 是防重复计算的标记位。
4.2 UV 是去重 IP,会话是 IP + 浏览器 + 30 分钟
UV        = count(distinct ip)
会话(sid) = md5(ip + ua)   会话间隔 30 分钟无活动算新会话
会话 ID 必须用 md5,不能用内置 hash()。Python 内置的 hash() 对字符串默认按随机种子加盐(PYTHONHASHSEED),跨进程不一致——同一个访客在 fetch 进程和 web 进程里算出两个不同的 sid,会话数直接翻倍。这是我踩过的坑,看到过会话数明显大于 UV 但排查不出原因,最后就是它。
4.3 停留时长用窗口函数算
不新建临时表,直接用 SQLite 的 LEAD() 窗口函数取同会话的下一次访问时间戳,差值就是停留。超过 30 分钟会话间隔的记为 NULL(视为已离开),防止「晚上 8 点浏览、第二天早上再访问」被算成 16 小时停留。
UPDATE visits SET dwell = s.d, dwell_calc = 1
FROM (
  SELECT id, CASE WHEN nts - ts BETWEEN 0 AND 1800
                  THEN nts - ts ELSE NULL END AS d
  FROM (
    SELECT id, ts, LEAD(ts) OVER (PARTITION BY sid ORDER BY ts, id) AS nts
    FROM visits WHERE kind='page' AND bot=0 AND ts >= ?
  ) WHERE nts IS NOT NULL
) AS s
WHERE visits.id = s.id AND visits.dwell_calc = 0;
五、机器流量怎么判:四层递进
这是整套统计里最有价值的部分。94.8% 的机器流量如果不剔干净,所有 PV/UV 数字都没意义。我用的判断分四层,从便宜到贵依次执行。
5.1 第一层:UA 关键词
最直接的一层。bot、spider、crawler 是基本盘,再加一批具体的工具名(ahrefs、semrush、petalbot、bytespider)。正则要写得足够长,宁可多匹配也别漏。
BOT_RE = re.compile(
    r"(bot|spider|crawler|crawl|slurp|archiver|scanner|monitor|ahrefs|semrush|"
    r"mj12|dotbot|bytespider|yisou|petalbot|applebot|nimbostratus|censys|expanse|"
    r"l9explore|masscan|zgrab|scrapy|python-requests|curl/|wget|libwww|"
    r"headlesschrome|okhttp|go-http-client|axios|node-fetch|java/|feedfetcher|"
    r"pingdom|uptimerobot|gtmetrix|lighthouse|HTTrack|Nutch|sistrix|seoscanners)",
    re.I)
5.2 第二层:命令注入痕迹
很多扫描器 UA 里不带 bot 字样,但它会把攻击载荷塞进去。UA 里出现 shell 命令注入痕迹的一律判机器,这一层性价比极高:
SHELL_RE = re.compile(
    r"($(|`|${|x[0-9a-fA-F]{2}|;s*(?:wget|curl|bash|sh|cat|ls|id)|"
    r"/bin/(?:ba)?shb|base64s|%00|
5.3 第三层:行为判定
光看 UA 抓不到「伪装成人」的扫描器。这一层不看单个请求,而是按 IP 聚合看行为。单个 IP 单日出现下列任一情况即判为机器:
| 判定条件 | 阈值 | 正常人上限 |
|---|---|---|
| 单日总请求数 | ≥ 400 | 翻完整个站点也不到 400 |
| 单日访问不同路径数 | ≥ 60 | 一天看 60 个不同页面不现实 |
| 单日会话数 | ≥ 20 | 会话数≈UA 轮换次数,人不会 |
| 单分钟请求数 | ≥ 25 | 人手速极限约 5~10 次/秒 |
「单日会话数 ≥ 20」这条特别有用,它抓的是轮换 UA 的爬虫——每次请求换一个 User-Agent,看起来每次都是全新访客。会话数突然等于请求数,一看就是机器。
5.4 第四层:探测路径
有个很巧的判据:整站历史上从未返回过 200 的路径,一定不是正常页面。把这类路径直接归为扫描:
UPDATE visits SET bot = 1, kind = 'scan'
WHERE bot = 0 AND kind = 'page' AND path IN (
  SELECT path FROM visits GROUP BY path
  HAVING SUM(CASE WHEN status = 200 THEN 1 ELSE 0 END) = 0
);
比如 /wp、/wordpress、/api/health、/.env——你的站点不可能有这些页面,那访问它们的 100% 是扫描器。这一层不需要任何阈值,纯统计事实,几乎零误判。
实测分布:44万条里 system 179,230 条、page 134,486 条、scan 83,784 条、static 42,565 条。注意 static(静态资源)只有 4.2 万条,占 9.7%——这就是开了整页缓存的直接结果。如果你的站静态资源占比很高(比如超过 50%),说明缓存没生效,页面可能比想象中慢。
六、搜索引擎爬虫辨真假:官方 IP 段 + DNS 反查
这是我认为整套系统里最有用的一块。看板上专门有一张「搜索引擎真实爬虫 · 按天」表,一眼就能看出哪个引擎真的在抓你。
6.1 为什么必须查IP 段
查这个站 20 天的日志,自称 Baiduspider 的请求有 675 条,但IP 落在百度官方段里的只有 104 条——另外 571 条(85%)是伪造 UA,来源是腾讯云海外(43.x 段)和 GCP(34.x / 35.199.x 段)的云主机,没有 PTR 记录。
这意味着:如果你只看日志里 User-Agent 字符串统计「百度来多少次」,会得出一个完全错误的结论。真实情况是百度一天只来 5.8 次,其余全是冒充的。
交叉验证过:看板算出的伪造率 84.3%,直接在 nginx 日志里 grep 那几个 IP 段手工统计是 84.6%,两者吻合,说明判定逻辑没漏。
6.2 三态判定:real / fake / unknown
关键设计:只有「IP 段稳定且官方公布」的引擎才硬判真假。AI 类爬虫和字节、华为、DuckDuckGo 这些,IP 段在云上漂移,硬判会大量误报,所以一律走 unknown + DNS 反查。
def judge(ip, key):
    """real    命中该引擎官方 IP 段
    fake    未命中,且该引擎有公开的 IP 段定义
    unknown 该引擎没有 IP 段定义,需走 DNS 校验"""
    if not ip or not key:
        return "unknown"
    nets = _nets(key)
    if not nets:
        return "unknown"
    for n in nets:
        if ip in n:
            return "real"
    return "fake"
引擎表里对 AI 类爬虫的处理最能体现思路——GPTBot、Claude、Perplexity、Google-Extended、Cohere 这些刻意不写 cidr,注释里写得很清楚:
# 可枚举的 IP 段。这里刻意不写 cidr —— 一律判 unknown,
# 由 PTR 双向校验定性,避免误判成伪造。
"openai": dict(name="OpenAI GPTBot", cat="ai", cidr=[], ptr=[".openai.com"]),
"anthropic": dict(name="Anthropic Claude", cat="ai", cidr=[], ptr=[".anthropic.com"]),
这个改动把误报率从第一版的 36.3% 收敛到 7.9%。
6.3 engine 字段的 NULL / 空串陷阱
看板能显示按引擎的统计,靠的是 engine 列,但它的语义定义很容易踩坑:
| 取值 | 含义 |
|---|---|
NULL |
尚未回填 |
空串'' |
已回填,且确认不是爬虫 |
| 引擎 key | 已回填,是该引擎 |
UPDATE visits SET engine = COALESCE(botfam(ua), '')
WHERE id IN (SELECT id FROM visits WHERE engine IS NULL LIMIT 40000);
不能直接用 NULL 表示「不是爬虫」,否则每轮增量同步都会把所有 NULL 行重新扫一遍,44 万行反复扫描CPU 白烧。用空串区分「判定过」和「没判定」,回填完记住 MAX(id),之后只有新增数据才再扫。
6.4 看板上的爬虫表长这样
下面是实际抓的图,这张表是判断「搜索引擎到底来不来」最直接的地方:
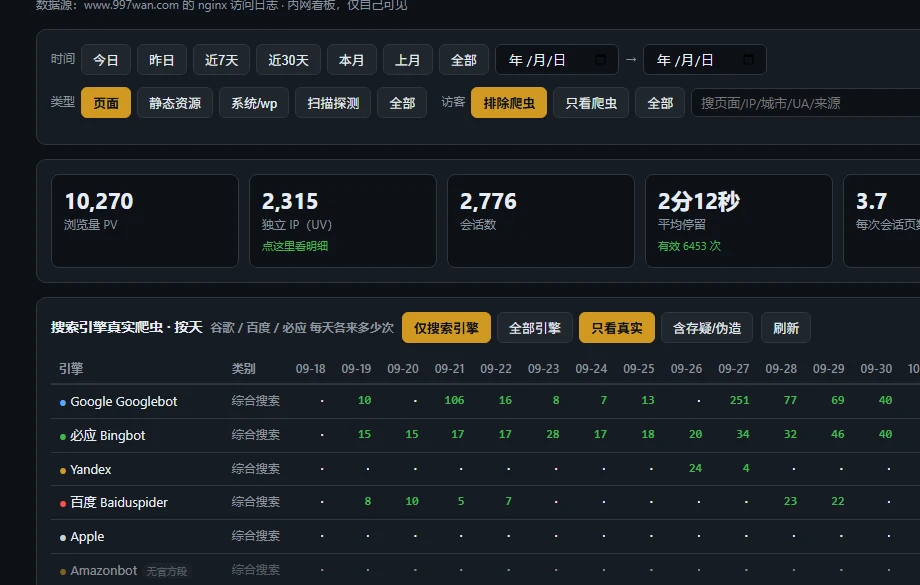
看 Googlebot 和 Bingbot 两行:Googlebot 20 天来 1,012 次(日均 50.6,来自 87 个 IP),Bingbot 956 次(日均 47.8,160 个 IP)——这两个是健康的。而下面 Amazonbot、字节、搜狗、华为、DuckDuckGo 全是 0,因为它们没有官方 IP 段定义走 unknown。要确认它们到底是真是假,得点上方 Top IP 的 DNS 做 PTR 双向校验。
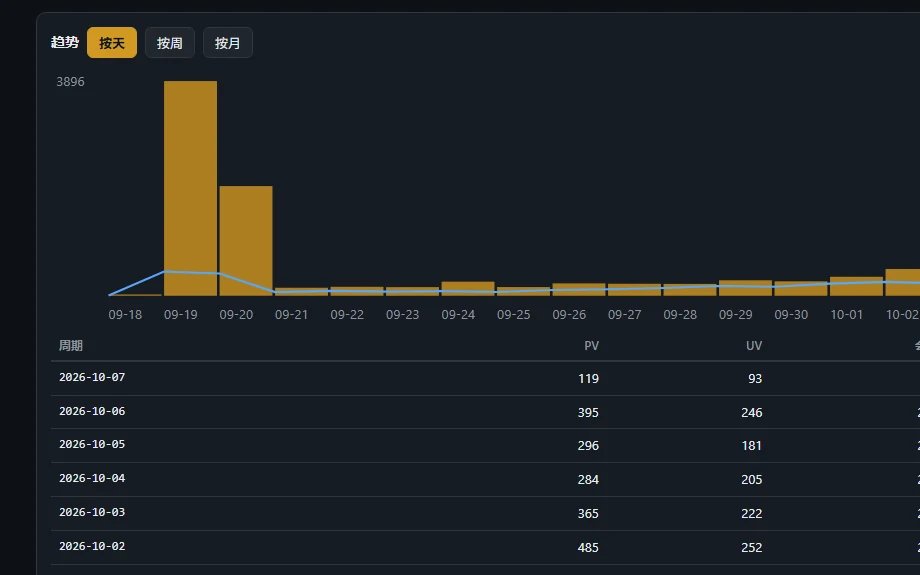
趋势图能看到明显的技术活儿痕迹:09-18 上线当天只有 23 次请求,09-19 冲高到 3,896(自己测试 + 被爬),之后就稳定在 150~480 这个区间。这个区间才是站点的真实水位,看板之外的东西都免谈。
七、看板前端:纯标准库,没有前端框架
后端是 Python 标准库的 http.server,前端是原生 JS + Canvas 画图表。这个选择很刻意:内网看板不需要框架,也不需要能被搜索引擎看到,越简单越不容易半夜挂掉。
7.1 十一个 JSON 接口
GET /api/overview   KPI 汇总
GET /api/trend按天/周/月趋势
GET /api/hourly     24 小时分布
GET /api/top        热门页面
GET /api/dist       归属地分布
GET /api/ips        独立 IP 列表(可翻页)
GET /api/ipdetail   某个 IP 的完整访问轨迹(最多 300 条)
GET /api/visits     明细流水
GET /api/bots       爬虫按天统计
GET /api/botverify  PTR 双向校验
GET /api/meta       总量、同步时间、offset
GET /api/export     导出 CSV
其中 /api/ipdetail 是最有用的调试接口。点任意一个独立 IP,能看到它的逐条访问轨迹:什么时间、访问了哪个页面、停留多久、从哪来、什么设备、返回什么状态码。怀疑「这个 IP 是不是我自己的」或者「这个流量哪来的」,看一眼就清楚了。
7.2 爬虫表的 WHERE 要独立
有个容易忽略的实现细节:爬虫统计接口的筛选条件只受时间范围约束,不受「页面/静态资源/系统」和「排除爬虫/只看爬虫」这些筛选影响。
def _bot_base(p):
    """爬虫模块专用 WHERE:只受时间范围约束,不受 kind/bot/关键词筛选影响。"""
    where = ["date >= ?", "date <= ?"]
    ...
    return "engine IS NOT NULL AND engine <> '' AND " + tw
原因很实际:你切到「只看爬虫」时,爬虫表必须还能正常显示;如果它跟着 bot 筛选走,切来切去表就空了。这是个纯交互上的细节,但第一次用的人往往会以为是 bug。
八、完整部署:五步走
8.1 第一步:站点端放两个 PHP 文件
n997-stats-export.php(只读导出,无token 返 403)和 n997-stats-snapshot.php(POST 带token 写快照到 wp_options,GET 公开只读给侧栏卡片用)。放站点根目录,权限和其他 PHP 一致即可。
8.2 第二步:统计机装依赖
apt install -y python3 sqlite3
mkdir -p /opt/n997stats/data
# ip2region 离线库放到 data/geo.db
8.3 第三步:写config.json
{
  "endpoint": "https://你的域名/n997-stats-export.php",
  "push_url": "https://你的域名/n997-stats-snapshot.php",
  "token": "换成一串够长的随机字符",
  "db": "/opt/n997stats/stats.db",
  "geo_db": "/opt/n997stats/data/geo.db",
  "site_host": "www.你的域名",
  "listen": "0.0.0.0",
  "port": 8089,
  "batch": 20000,
  "session_gap": 1800,
  "max_dwell": 1800
}
session_gap 是会话间隔秒数(1800 = 30 分钟),max_dwell 是停留时长的上限,超过就记 NULL。这两个值决定 UV 之外的「会话数」和「平均停留」怎么算。
8.4 第四步:systemd 定时同步
[Unit]
Description=997wan stats fetch + push

[Service]
Type=oneshot
ExecStart=/bin/bash /opt/n997stats/sync.sh
[Timer]
OnBootSec=2min
OnUnitActiveSec=5min
Persistent=true
[Install]
WantedBy=timers.target踩过的坑:改 systemd unit 必须装到 /etc/systemd/system/。把 .service 放在 /opt/n997stats/ 里改是不生效的——那里只是源文件副本。我为此白排查了一轮。正确流程:cp /opt/n997stats/xxx.service /etc/systemd/system/ 然后 systemctl daemon-reload。
8.5 第五步:验证
systemctl status n997stats-web          # 看看板
systemctl list-timers n997stats-fetch   # 看定时
systemctl start n997stats-fetch.service   # 手动跑一次
python3 /opt/n997stats/push.py --dry      # 只看快照不推送
python3 /opt/n997stats/geo.py --test 220.181.108.1  # 测归属地
curl -s localhost:8089/api/meta全站部署完成,网站前台一行代码都没改,只多了两个 PHP 文件在根目录(token 保护、不进索引)。侧栏卡片从 v1.1.1 起只读快照,数字和看板完全一致。
九、这些坑我替你踩过了
| 坑 | 症状 | 正解 |
|---|---|---|
会话 ID 用 hash() |
会话数莫名翻倍 | 必须 md5,Python hash 跨进程不一致 |
| engine 用 NULL 当「非爬虫」 | 每轮同步全表重扫,CPU 空烧 | 空串区分已判定/未判定,记 MAX(id) |
| AI 爬虫硬判真假 | 误报率 36.3% | 不写 cidr,走 unknown + DNS(降到 7.9%) |
| 自然周当近 7 天 | 周一看「近7天」等于今日,像坏了 | 改滚动窗口 |
| systemd unit 改错目录 | 改了不生效 | 装到 /etc/systemd/system/ 再 daemon-reload |
| 停留用会话间隔算 | 隔夜访问算出 16 小时停留 | 超过 max_dwell 记 NULL |
| 两边数字打架 | 看板和卡片对不上 | 卡片不再自己计数,只读快照 |
| 按日志全量重导 | 越滚越慢 | 按字节 offset 增量 + inode 检测轮转 |
十、这套方案适合什么,不适合什么
说点实在的,避免你照抄之后发现用不上。
10.1 适合
- 个人站、博客、小站,PV 在几千到几万之间
- 想看搜索引擎到底来不来、被谁扫描,不需要广告投放数据
- 数据必须留在自己手里,不想装cookie 弹窗、不想被第三方看到访客 IP
- 有台常开的机器(NAS、软路由、小主机都行)
10.2 不适合
- 日请求十万级以上——SQLite 会吃力,该上 ClickHouse 或日志分析平台
- 需要用户行为视频、滚动深度、点击热图——日志做不到,必须埋 JS
- 多站点统一管理——这套是单站点设计,多站要重新设计聚合层
- 没有常开设备——纯云环境跑不了,看板要长期在线
如果只能记一条:先把统计口径定下来,再写代码。UV 是 IP还是会话、近 7 天是滚动还是自然周、机器流量算不算 PV——这三个问题不定清楚,看板做出来也会自相矛盾,最后你还是会回到「到底该信哪个数字」的困境。我这个看板返工过一次,就是因为先把界面做完了才想起口径的事。
写在最后
这套东西从零做到能用,前后花的时间比想象的多,中间的坑有一半是「想当然」踩出来的。最有价值的不是看板本身,而是它逼着我把统计口径想清楚——当你真的开始区分「哪些请求是访客、哪些是机器」之后,你会发现很多以前模模糊糊的流量问题,忽然有了明确的答案。
比如它告诉我这个站 94.8% 的流量是机器,比如它告诉我自称百度的那 675 条里571 条是假的。这些数字改变不了什么,但至少让我不再为一个虚假的数字去优化页面。
- 文章名称:不埋点也能做网站访问统计看板:解析 nginx 日志全流程
- 文章永久网址:https://www.997wan.com/nginx-log-access-stats-dashboard/
- 本网站的文章部分内容可能来源于网络,仅供大家学习与参考,如有侵权,请联系站长 997笔记 进行删除处理。
- 本站一切资源不代表本站立场,并不代表本站赞同其观点和对其真实性负责。
- 本站一律禁止以任何方式发布或转载任何违法的相关信息,访客发现请向站长举报
- 本站资源大多存储在云盘,如发现链接失效,请联系我们我们会第一时间更新。
- 如无特别声明本文即为原创文章仅代表个人观点,版权归《997笔记》所有,欢迎转载,转载请保留原文链接。