上午同时刷到两条新闻:OpenAI 把 GPT-6 的轻量版 Luna 下放给全部免费用户,付费用户继续用旗舰版 Sol;同一时间上线的… 全文依次覆盖:先把这轮更新的事实摆一遍、AI 爬虫的画像、我的放行策略,和刚刚上线的 llms.txt、两个意外发现、伪装成内容爬虫的扫描器、空的 robots.txt 也会被反复确认、给站长的行动清单。
上午同时刷到两条新闻:OpenAI 把 GPT-6 的轻量版 Luna 下放给全部免费用户,付费用户继续用旗舰版 Sol;同一时间上线的「智能 UI」能在对话框里现场渲染图表、表单和可交互组件。另一条是财务口径的回顾——ChatGPT 的广告业务上线六周,年化收入就过了一亿美元。
别人的第一反应可能是「模型又强了」,我的第一反应是登上服务器,把 nginx 日志翻出来。理由很简单:如果流量入口真的从搜索框迁向对话框,那么最先感知到的不是我订阅了哪个模型,而是我网站的日志里出现了谁。
本文就是把这次翻日志的完整记录:26 天、50.6 万次请求里,内容抓取方的构成、它们各自来干什么、我的放行策略,以及两个意外发现。文章涉及的产品事实部分参考了公开报道(文末注明),日志数据全部来自本站真实记录。
先把这轮更新的事实摆一遍
为了避免后面聊跑偏,先把公开报道口径的关键事实列出来。我关心的不是「GPT-6 多强」,而是每一条对站长意味着什么。
| 事实 | 数字 | 站长的视角 |
|---|---|---|
| GPT-6 Luna 全量免费 | 免费用户首次拿到最新模型,付费用户用旗舰 Sol | 用大模型做工具、写脚本的成本门槛继续下探 |
| ChatGPT 广告化 | 上线 6 周年化收入破 1 亿美元,600+ 广告主,CPM 超 60 美元 | 广告预算开始流向「对话内」,传统展示广告的存量被切 |
| 智能 UI 上线 | 按任务现场渲染图表、表单、可交互组件 | 「对话内完成决策」成为可能,跳转链接的价值被压缩 |
| 财务背景 | 2025 年营收约 130 亿美元、净亏损约 80 亿;2026 年 3 月 Sora 项目关停 | 广告与规模扩张是一条因果链,不是临时起意 |
| 搜索大盘 | 公开口径:生成式问答已占搜索类查询约 52%,传统搜索流量下滑约 25% | 这就是为什么「被谁引用」开始变得和「被谁收录」一样重要 |
一条一条看下来,OpenAI 在拆三堵墙:模型墙(免费也用得上新模型)、订阅墙(收入结构转向广告)、对话墙(决策闭环锁在对话框里)。这三堵墙对普通网站的影响方式不同,但方向一致——流量入口的定义正在被改写。
26 天日志实测:AI 爬虫的画像
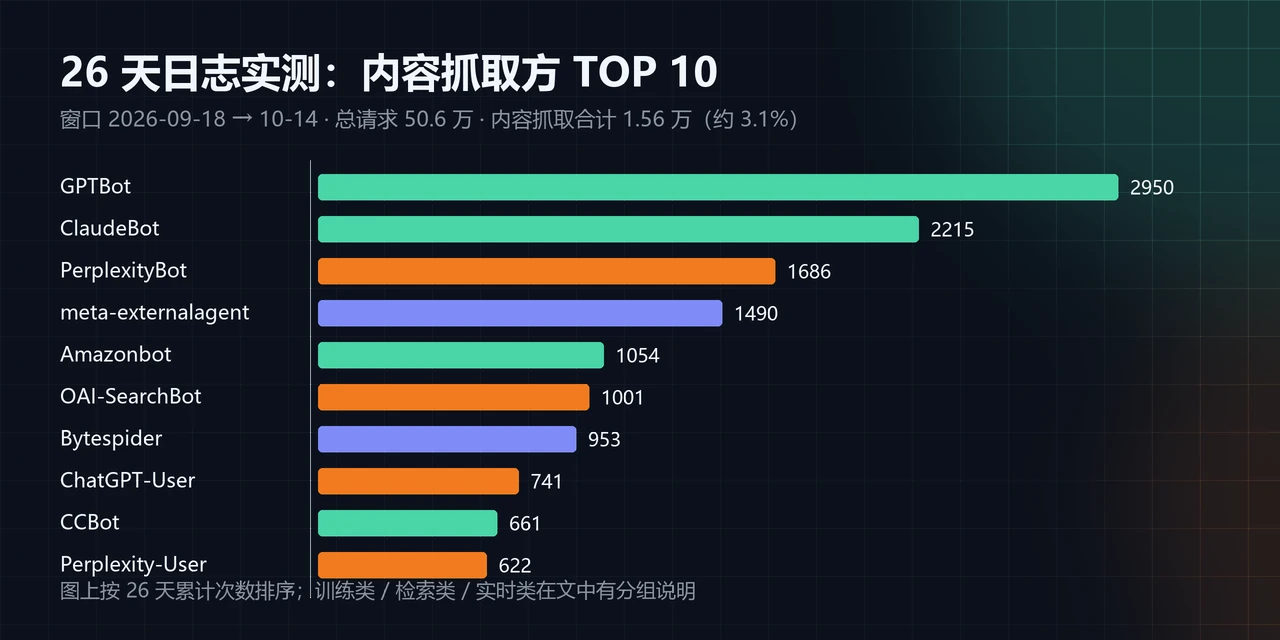
我的日志窗口是 2026-09-18 到 10-14,共 26 天,506,473 次请求。按「拿内容去干什么」把内容抓取方分成三类,合计 15,559 次,占总请求的约 3.1%。
| 类别 | 代表 UA | 26 天抓取 | 它们拿内容去干什么 |
|---|---|---|---|
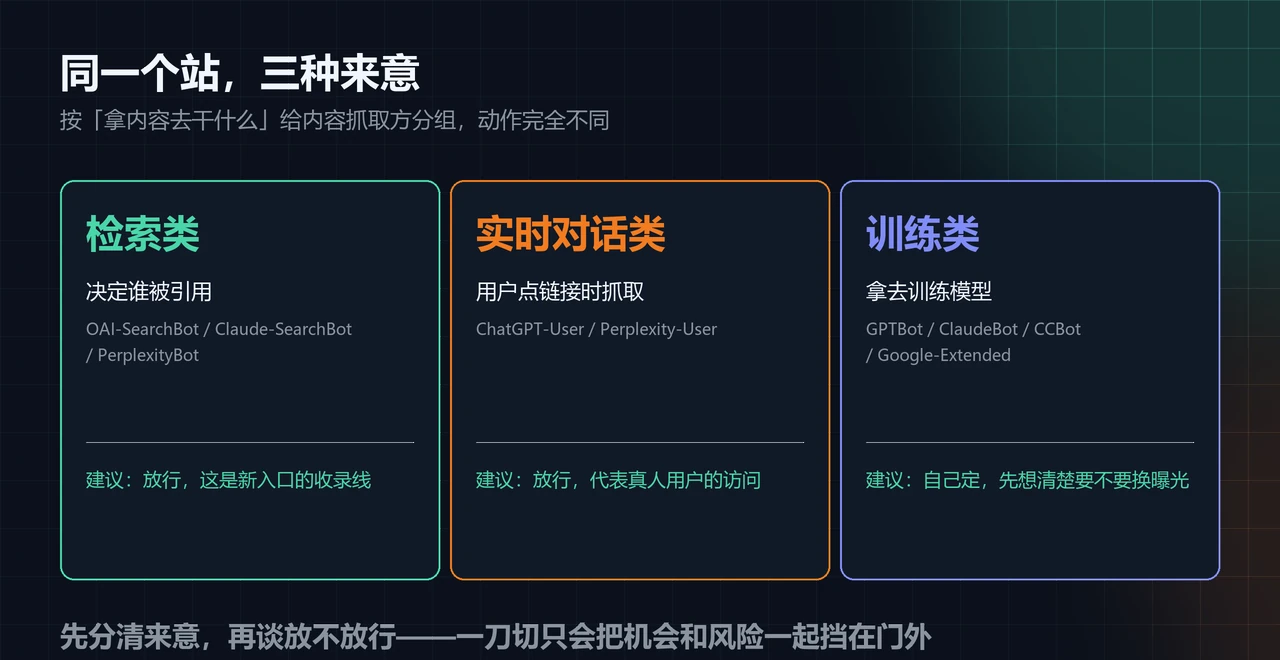
| 训练类 | GPTBot(2950)、ClaudeBot(2215)、CCBot(661)、Google-Extended(525) | ≈ 6351 | 进训练语料,影响的是「未来模型会不会提到你」 |
| 检索类 | PerplexityBot(1686)、OAI-SearchBot(1001)、Claude-SearchBot(564) | ≈ 3251 | 建索引,决定「用户提问时会不会引用你」 |
| 实时对话类 | ChatGPT-User(741)、Perplexity-User(622) | ≈ 1363 | 真人用户在对话里点开链接时才抓,是真实的间接流量 |
| 其他 | meta-externalagent(1490)、Amazonbot(1054)、Bytespider(953)、YouBot(581)、cohere-ai(516) | ≈ 4594 | 各家策略不一,需按家单独判断 |
几个我没想到的点:GPTBot 是全站最勤快的抓取方(2950 次,超过任何一家传统搜索引擎 Bot 的抓取频次);Perplexity 全家桶加起来超过 2300 次;ChatGPT-User 出现了 741 次——意味着已经有不少真实用户在对话里点开过本站的链接。
我的放行策略,和刚刚上线的 llms.txt
分清来意之后,我的选择是:检索类和实时对话类全放行——前者是新一代入口的收录线(类似当年的 sitemap),后者代表真实用户的访问;训练类暂时也放行,理由是我希望内容进入模型的语料,换取长期「被提及」的可能性。这笔账每个站算出来的结果不同,但前提是先有日志数据。
放行只是第一步,还得给它们「指路」。检查了一下,我的 robots.txt 一直是空的(全放行),而 llms.txt 压根没建——这次顺手补上了。llms.txt 是一个还在演进中的约定:放在站点根目录,用 Markdown 向语言模型介绍「这个站是谁、哪些内容最重要」。抓取方在分配抓取预算时,这样的文件能明显降低理解成本。
我上线的内容节选(完整文件可直接访问 /llms.txt):
# 997笔记

> 大番茄的网络折腾笔记。以「真实踩坑 + 可复现实验」为主的中文技术博客:
> 软路由 OpenWrt / iStoreOS、PVE 虚拟化、MosDNS / AdGuard Home 与加密 DNS 实测。

## 加密 DNS 与网络
- [DoH/DoT 服务清单:国内外常用加密 DNS 汇总](https://www.997wan.com/doh-dot-service-list/)

## 虚拟化与 NAS
- [PVE 镜像与虚拟机安装教程](https://www.997wan.com/pve-img-vm-install-tutorial/)

## 运维与命令速查
- [SSH 密钥登录教程](https://www.997wan.com/ssh-key-login-tutorial/)
- [Linux 常用命令速查](https://www.997wan.com/linux-command-cheatsheet/)
除了 llms.txt,GEO(面向生成引擎优化)还有几件事是低成本高回报的:文章标题直接回答一个具体问题、结论前置、关键数据用表格呈现、每篇文章有清晰的一句话定义。这些恰好也是对人类读者友好的写法——对模型友好的写法和对人友好的写法,重叠度远比想象中高。
两个意外发现
一、伪装成内容爬虫的扫描器
拆数据时发现一个不舒服的事实:部分打着内容抓取 UA 的请求,抓的既不是文章也不是 sitemap,而是 /config/.env、/src/.env、/docker-compose.yaml、/service_account.json 这类敏感文件——每个路径都有二三十次尝试。UA 是可以随便伪装的,别把 UA 当身份凭证。
应对很简单:这些路径本来就不该存在于 Web 目录,而且值得在 nginx 里直接封死。我加了一条:
# 站点 server 块内:敏感文件一律 444(不回包直接断开)
location ~* \.(env|yaml|yml|json\.bak)$ { return 444; }
location ~* /(config|src|app|service_account)\.(env|json)$ { return 444; }
顺便提醒:如果你的站也在被同样的路径扫,先确认这些文件真的不在 Web 根目录下,再上规则。
二、空的 robots.txt 也会被反复确认
26 天里 /robots.txt 被请求了 225 次,其中 OAI-SearchBot 一家就占了 209 次。有意思的是我的 robots.txt 是空的——即便是空文件,检索类爬虫也会反复回来确认规则没有变化。这反而说明它们的规矩比想象中好:真正乱来的(比如扫 .env 的那些),根本不看这个文件。
给站长的行动清单
| 事项 | 动作 | 成本 |
|---|---|---|
| 看清现状 | 在 nginx 日志里按本文的 UA 清单统计一遍,知道自己被谁抓、抓什么 | 10 分钟 |
| 分类放行 | 检索类 / 实时类放行;训练类想清楚「换曝光还是保内容」再定 | 30 分钟 |
| 上线 llms.txt | 站点根目录放一份,介绍站点定位与最重要的文章清单 | 30 分钟 |
| 补齐敏感文件防护 | 确认 .env 等不在 Web 目录,nginx 加 444 规则 | 15 分钟 |
| 内容结构化 | 标题回答具体问题、结论前置、数据用表格——同时服务人和生成引擎 | 长期习惯 |
结语:日志是站长唯一的仪表盘
这轮更新之后,「入口」的定义被改写了两层:模型免费把用户面拉大,智能 UI 把决策场景锁进对话框。对内容站来说,SEO 还没死,但它正在从唯一的入口变成入口之一——另一个入口是「被生成引擎在回答里引用」。
好消息是,这个新入口的规则目前非常朴素:内容可抓取、结构清晰、实体明确、数据真实。坏消息是,它和 SEO 一样需要长期积累,没有开关可以一键打开。
而无论入口怎么变,站长的仪表盘始终是自己的日志。品牌方看大盘数据,我们看自己的 access log——这次 26 天的数据至少告诉我一件事:新的读者已经在路上了,别把门关死。
- 文章名称:GPT-6 免费之后,我翻了 26 天网站日志:AI 爬虫比想象中勤快
- 文章永久网址:https://www.997wan.com/gpt6-free-ai-crawlers-nginx-log/
- 本网站的文章部分内容可能来源于网络,仅供大家学习与参考,如有侵权,请联系站长 997笔记 进行删除处理。
- 本站一切资源不代表本站立场,并不代表本站赞同其观点和对其真实性负责。
- 本站一律禁止以任何方式发布或转载任何违法的相关信息,访客发现请向站长举报
- 本站资源大多存储在云盘,如发现链接失效,请联系我们我们会第一时间更新。
- 如无特别声明本文即为原创文章仅代表个人观点,版权归《997笔记》所有,欢迎转载,转载请保留原文链接。