AI在大学生中普及率近99%,但系统会用的不足三成。市场正重奖能把AI用进业务的人,提示词、智能体等岗位增速远超算法岗。学习应重提问、流程、验证与项目成果。结论是:不是AI淘汰人,而是会用AI的人把不会用的人挤出去,AI只是放大器。
先说两组数字,摆在一起看有点刺眼。
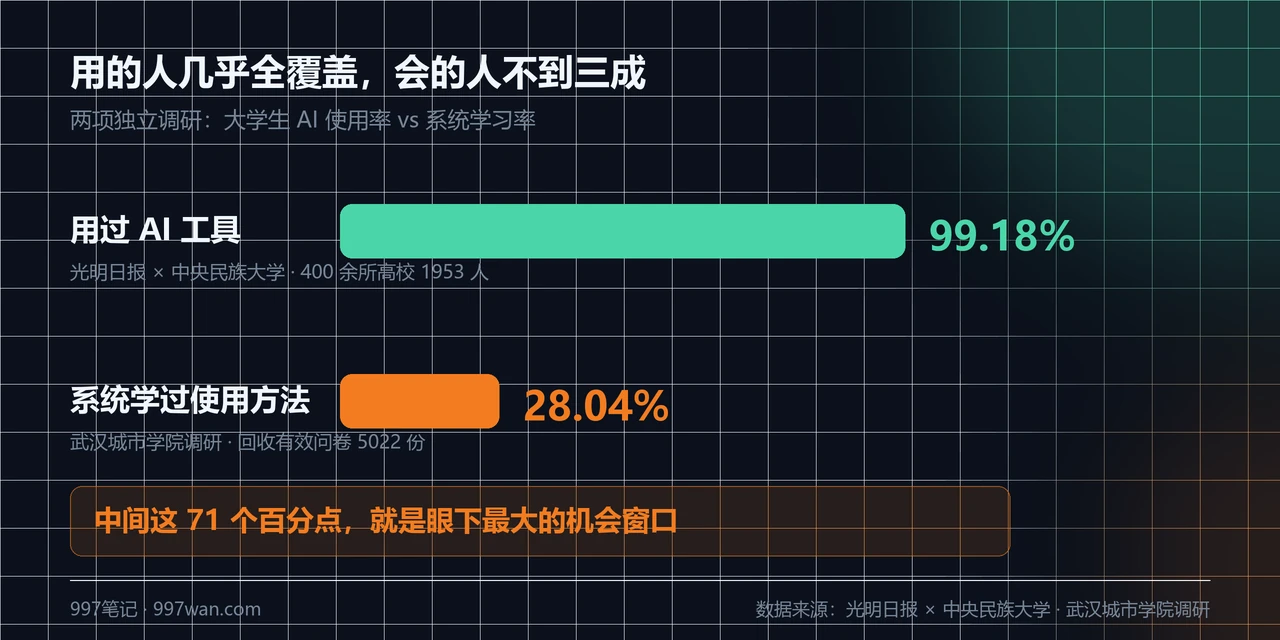
第一组来自光明日报和中央民族大学研究团队做的一项调研,覆盖全国 400 余所高校、1953 名本科生:AI 工具在大学生中的使用率是 99.18%,只有 0.82% 的人从没碰过。
第二组来自武汉城市学院一个调研团队,回收有效问卷 5022 份:只有 28.04% 的学生系统学习过 AI 工具的使用方法,接近七成的人属于「简单用用」或者「边用边摸索」。
也就是说,一百个人里九十九个在用 AI。但真正知道自己在干什么的,不到三十个。
这篇文章想聊的就是这中间七十个人的落差:现在市面上到底有哪些模型,市场愿意为哪些能力付钱,以及一条不用绕弯的学习路线。
一、先看清楚:大家到底在用 AI 做什么
同一份光明日报的调研里,还有几个数字值得单独拎出来看。
| 使用场景 | 占比 |
|---|---|
| 规划旅行、制定预算 | 46.72% |
| 辅助制作简历、准备面试 | 42.69% |
| 遇到问题首先求助 AI | 24.42% |
| 遇到问题首先求助朋友 | 24.94% |
最后两行值得多看两秒。「先问 AI」和「先问朋友」已经基本打平了。
AI 从「一个工具」变成了「一个可以商量的人」。这个转变本身没什么不好,但它带来一个副作用:跟人商量的时候你还会反问一句「真的吗」,跟 AI 商量的时候,多数人只是点了发送,然后等答案。
更值得注意的是场景分层。调研发现,双一流院校的学生主要把 AI 用在科研、竞赛和职业规划上;普通本科和高职学生,则大多停在作业辅助、文案修改这类基础用途。
同一个工具,有人拿它做杠杆,有人拿它抄作业。三年后这两批人的差距,不会只是「会不会用 AI」的差距。
这不是中国独有的现象。英国 2026 年的一项学生生成式 AI 调查显示,95% 的学生在用 AI,但另有研究发现 58% 的学生认为自己缺乏足够的知识和技能把 AI 用好。用得广,不等于用得对。
二、市场那一端:钱正在流向哪里
如果说「不会用 AI」在过去两年还只是一种可能性,那现在的招聘数据已经把它写成了明码标价。
猎聘大数据研究院在 2026 世界人工智能大会上发布的报告显示,中国人工智能核心产业规模已突破 1.2 万亿元,而人才缺口超过 500 万。人工智能工程师的需供比达到 2.62——平均每个求职者对应约 2.6 个岗位。在汽车研发制造领域,这个数字更是高达 8.2。
薪酬方面,AI 相关岗位的月薪中位值达到 25340 元,算法类岗位平均月薪普遍超过 2.8 万元,具备十年以上经验的从业者年薪中位数是 55.20 万元。
但真正有意思的不是薪资绝对值,而是岗位增速的差异。
| 岗位 | 同比增速 |
|---|---|
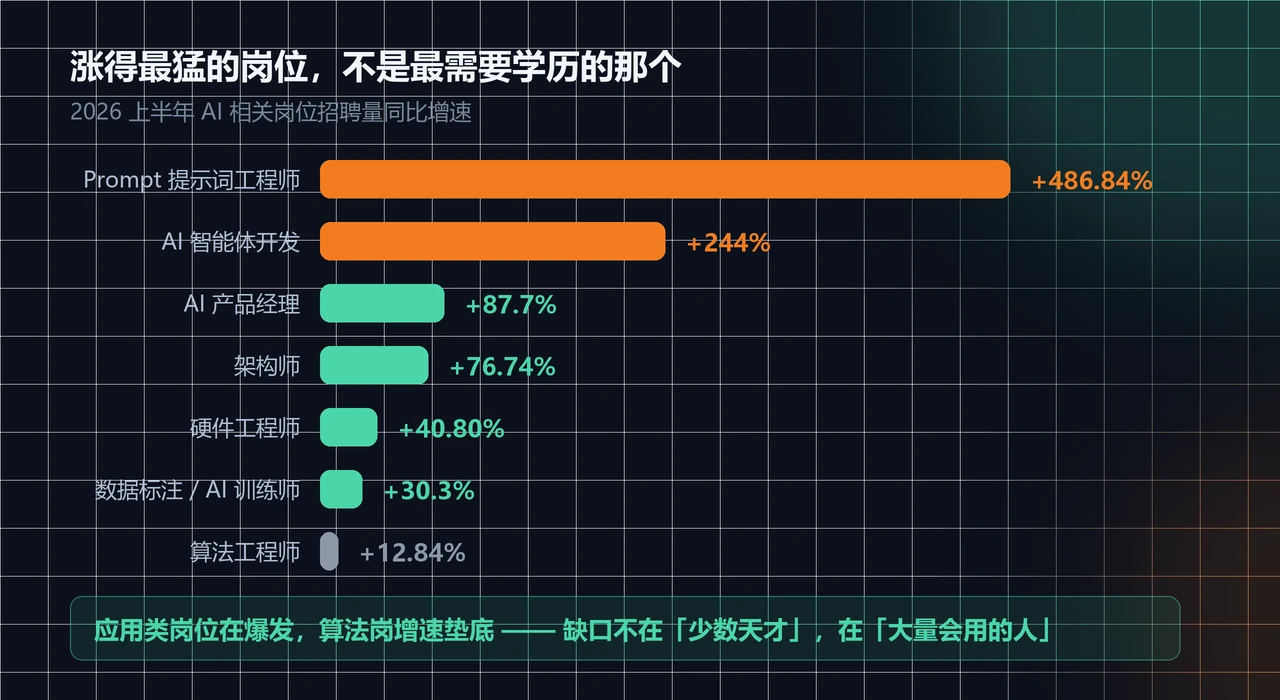
| Prompt 提示词工程师 | +486.84% |
| AI 智能体开发 | +244% |
| AI 产品经理 | +87.7% |
| 架构师 | +76.74% |
| 硬件工程师 | +40.80% |
| 数据标注 / AI 训练师 | +30.3% |
| 算法工程师 | +12.84% |
请重点看第一行和最后一行。
涨得最猛的是提示词工程师,一年翻了近五倍,平均年薪约 34.31 万元。而传统认知里最「正统」的算法工程师岗位,增速只有 12.84%,垫底。
这个结构说明一件事:市场缺的不是会推导公式的人,而是能把 AI 真正用进业务里的人。算法岗卷学历、卷论文,是少数人的赛道;而提示词、工作流、智能体这些方向,门槛低得多,需求却在爆发。
三、模型清单:现在有哪些工具可以用
很多人对 AI 的认知停在「千问」和「豆包」这两个名字上。它们的体验确实好,但只是一个入口。下面把当前主流的模型按国内外分开列一遍。
1. 国内可用(无需额外网络条件)
参考 SuperCLUE 在 2026 年 7 月放出的中文大模型测评,12 款主流模型参与,权重分布是智能体编程 25%、数学推理 18%、科学推理 16%、精确指令遵循 16%、幻觉控制 16%、智能体任务规划 9%。
| 模型 | 厂商 | 综合分 | 特点 |
|---|---|---|---|
| Qwen3.8-Max | 阿里 | 71.48 | 综合第一,幻觉控制与任务规划断层领先 |
| Kimi-K3 | 月之暗面 | 70.68 | 智能体编程全场第一(75.79) |
| 豆包 Seed 2.1 Pro | 字节 | 65.95 | 科学推理最强(77.19),交互门槛最低 |
| DeepSeek-V4-Flash | 深度求索 | 65.60 | 数学推理最强(78.95),性价比极高 |
| DeepSeek-V4-Pro | 深度求索 | 64.40 | 代码与逻辑扎实,开源可本地部署 |
除了这几个,文心一言(百度)在搜索增强和中文润色上依然能打,智谱 GLM 系列在学术严谨度和私有化部署上有优势,讯飞星火则在语音识别和教育场景里更专业。选哪个不是最重要的,重要的是别只用一个。
2. 海外第一梯队(作为对照)
按 rank.ai 综合四个主流榜单的结果(数据截至 2026 年 10 月 13 日):
| 模型 | 厂商 | 综合分 |
|---|---|---|
| Claude Fable 5 | Anthropic | 85 |
| GPT-5.6 Sol | OpenAI | 84 |
| Claude Opus 5 | Anthropic | 83 |
| GPT-5.5 | OpenAI | 82 |
| Kimi K3 | 月之暗面 | 82 |
| Gemini 3 Pro | 80 |
这张表里最值得中国人注意的是第五行——Kimi K3 是唯一挤进全球前五的国产模型,和 GPT-5.5 同分。
另外两个数据点:性价比最高的是 DeepSeek V4 Flash,每百万 token 只要 0.095 美元;而在代码和 Agent 能力上,Claude Opus 5 目前仍是第一梯队。这些信息的意义在于——你不需要为「哪个最好」纠结,你需要知道「什么场景该用哪个」。
四、怎么学:一条不用绕弯的路线
下面这条路线不假设你有任何编程基础,也不要求你先把数学补起来。
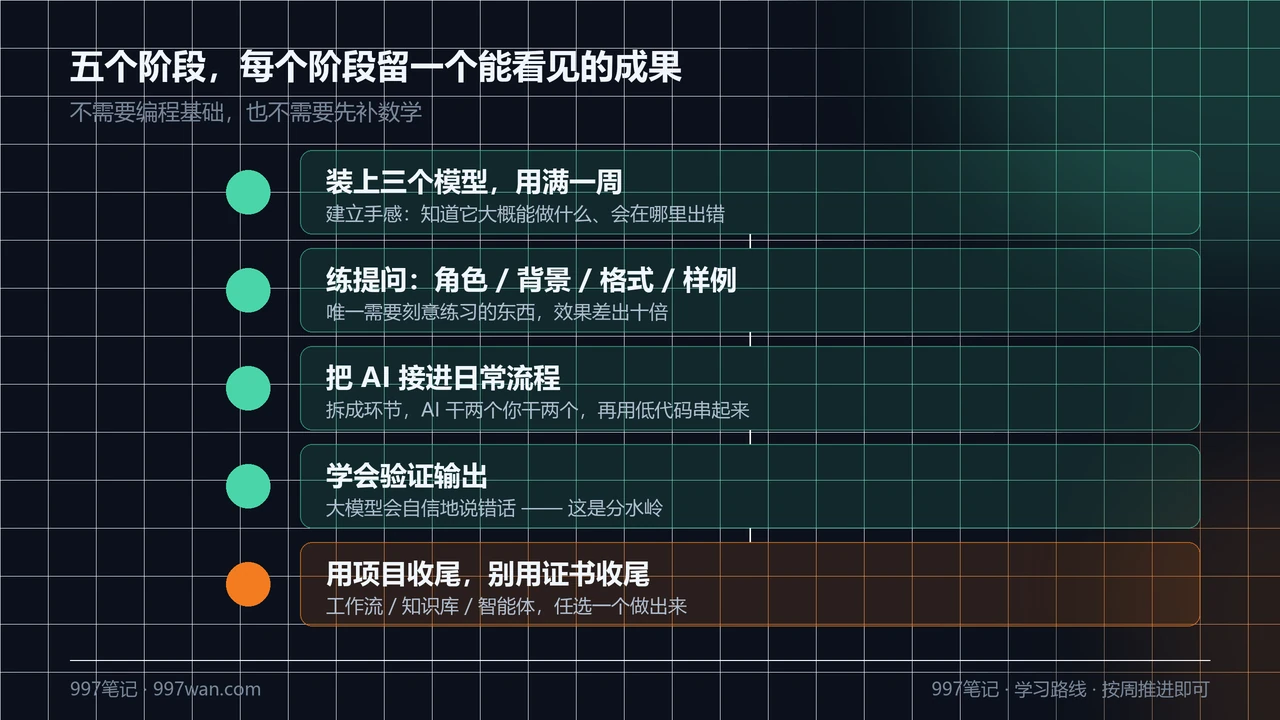
第一步:先装上三个,用满一周
别一上来就研究原理。先装两个国内模型(比如千问 + DeepSeek)加一个搜索型工具,然后强迫自己这一周所有需要查资料、写文字、算数据的活儿都先过一遍 AI。
这一步的目标不是学会什么技巧,而是建立手感:知道它大概能做什么、会在哪里出错。
第二步:练提问,这是唯一需要刻意练习的东西
同一个模型,问法不同,结果能差出十倍。结构化提问的基本盘是四件事:
- 给角色:你是谁,站在什么立场回答
- 给背景:这件事的前因后果、约束条件是什么
- 给格式:要表格、要分点、要多少字
- 给样例:如果你心里有「对的样子」,直接贴一个给它看
把这四件事补齐,你会立刻感觉到输出质量的变化。这也是为什么提示词岗位的招聘量一年翻了近五倍——它本质上是「把需求讲清楚」的能力,而这件事实在太多人做不好。
第三步:把 AI 接进你的日常流程
单次对话能做的事有限。真正拉开差距的,是把它变成流程的一部分。
举个最普通的例子:整理一份行业资料,可以拆成「批量丢给 AI 提取要点 → 人工判断哪些有用 → 让 AI 按你的框架重写 → 你自己做最终核对」。四个环节里 AI 干两个,你干两个。
到这个阶段,可以开始用 Coze、Dify 这类低代码平台把重复环节串起来,不需要写代码。
第四步:学会验证,这是分水岭
大模型是按概率生成文本的,不是查数据库。它可以用非常确定的语气说出完全错误的内容。
复旦大学的校长在今年开学典礼上提醒新生警惕三个词:认知卸载、虚假掌握、信息茧房。翻译成大白话就是——你以为你学会了,其实你只是抄完了。
所以每一条要用的 AI 输出,都该过一遍:这个说法能查到出处吗?数字对得上吗?如果错了,代价有多大?会验证的人和不验证的人,用同一个模型,得到的是两种人生。
第五步:用项目收尾,别用证书收尾
学完一圈,一定要留下能拿出手的东西,比如:
- 一套你自己反复在用的工作流(哪怕只是周报生成)
- 一个装了你行业资料的知识库
- 一个能自动跑完某件小事的智能体
- 一份用 AI 辅助完成的真实作品
五、关于「被淘汰」,说点实在的
先说结论:不是 AI 淘汰人,是会用 AI 的人正在把不会用的人挤出去。这两句话听起来差不多,但含义完全不同。
前者意味着你无能为力,后者意味着你现在动手还来得及。
更准确的说法是,AI 目前更像一台放大器。它放大的是你原本就有的东西——如果你判断力还行,它能把你变成三个你;如果你本来就分不清对错,它只会让你更快地犯错。
所以这件事从来不是「学不学 AI 工具」的问题,而是「你有没有值得被放大的东西」的问题。
回到最开始那两组数字。99.18% 和 28.04% 之间的七十个百分点,就是眼下最大的机会窗口。当所有人都在用 AI 的时候,「会用」本身就成了稀缺品。
而这个窗口不会一直开着。三年前「会用 Excel 数据透视表」还能写进简历,现在没人看了。
六、一份可以今天就动手的清单
- 今天:注册两个不同厂商的模型(比如千问 + DeepSeek),各问十个你工作或学习里的真实问题,对比答案差异
- 本周:把「给角色 / 给背景 / 给格式 / 给样例」这套提问框架用满二十次
- 本月:找一件你每周都要重复做的事,用 AI 把它压到原来一半的时间
- 本季度:产出一个能拿出手的成果——工作流、知识库或者小工具都行
- 持续:每周花半小时看看模型榜和岗位榜,知道自己站在哪
前面提到的那位复旦新生说了一句话,金力校长专门让大家为他鼓掌。他说 AI 时代要练三件事:一是提好问题,二是练判断力,三是敢担责。
这三件事,恰好是 AI 最不擅长的。也是你唯一不会被替代的部分。
如果你正在折腾家里的服务器或者网络,这份「先理解再动手」的思路其实一样管用,可以看看这两篇:MosDNS 实时统计面板、Nginx 访问日志可视化看板——工具换来换去,看清数据流向的思维方式是不变的。
- 文章名称:99% 的人在用 AI,真正会用的只有 28%
- 文章永久网址:https://www.997wan.com/ai-usage-vs-ai-skill-gap/
- 本网站的文章部分内容可能来源于网络,仅供大家学习与参考,如有侵权,请联系站长 997笔记 进行删除处理。
- 本站一切资源不代表本站立场,并不代表本站赞同其观点和对其真实性负责。
- 本站一律禁止以任何方式发布或转载任何违法的相关信息,访客发现请向站长举报
- 本站资源大多存储在云盘,如发现链接失效,请联系我们我们会第一时间更新。
- 如无特别声明本文即为原创文章仅代表个人观点,版权归《997笔记》所有,欢迎转载,转载请保留原文链接。